共计 8014 个字符,预计需要花费 21 分钟才能阅读完成。
在机器学习和深度学习算法的生命周期中,“评估指标(Evaluation Metrics)”如同模型的“眼睛”与“方向盘”。若指标选取不当,不仅会导致模型优化方向南辕北辙,甚至会在实际生产上线时引发灾难性后果(例如:在正样本仅占 0.1% 的欺诈检测场景下,一个将所有样本无脑猜为正常的废品模型,准确率却高达 99.9%)。
不同任务场景(分类、回归、排序与推荐、聚类)有着截然不同的评估维度。本文为你全面、系统地梳理机器学习各大核心任务中评价指标的计算公式、几何与物理意义、适用场景及避坑法则,并配备高质量原理架构图供深度理解与工作速查。
一、分类任务评价指标(Classification)
在二分类及多分类问题中,绝大多数评估指标均以混淆矩阵(Confusion Matrix)为计算基石。
0. 核心基石:二分类混淆矩阵(Confusion Matrix)
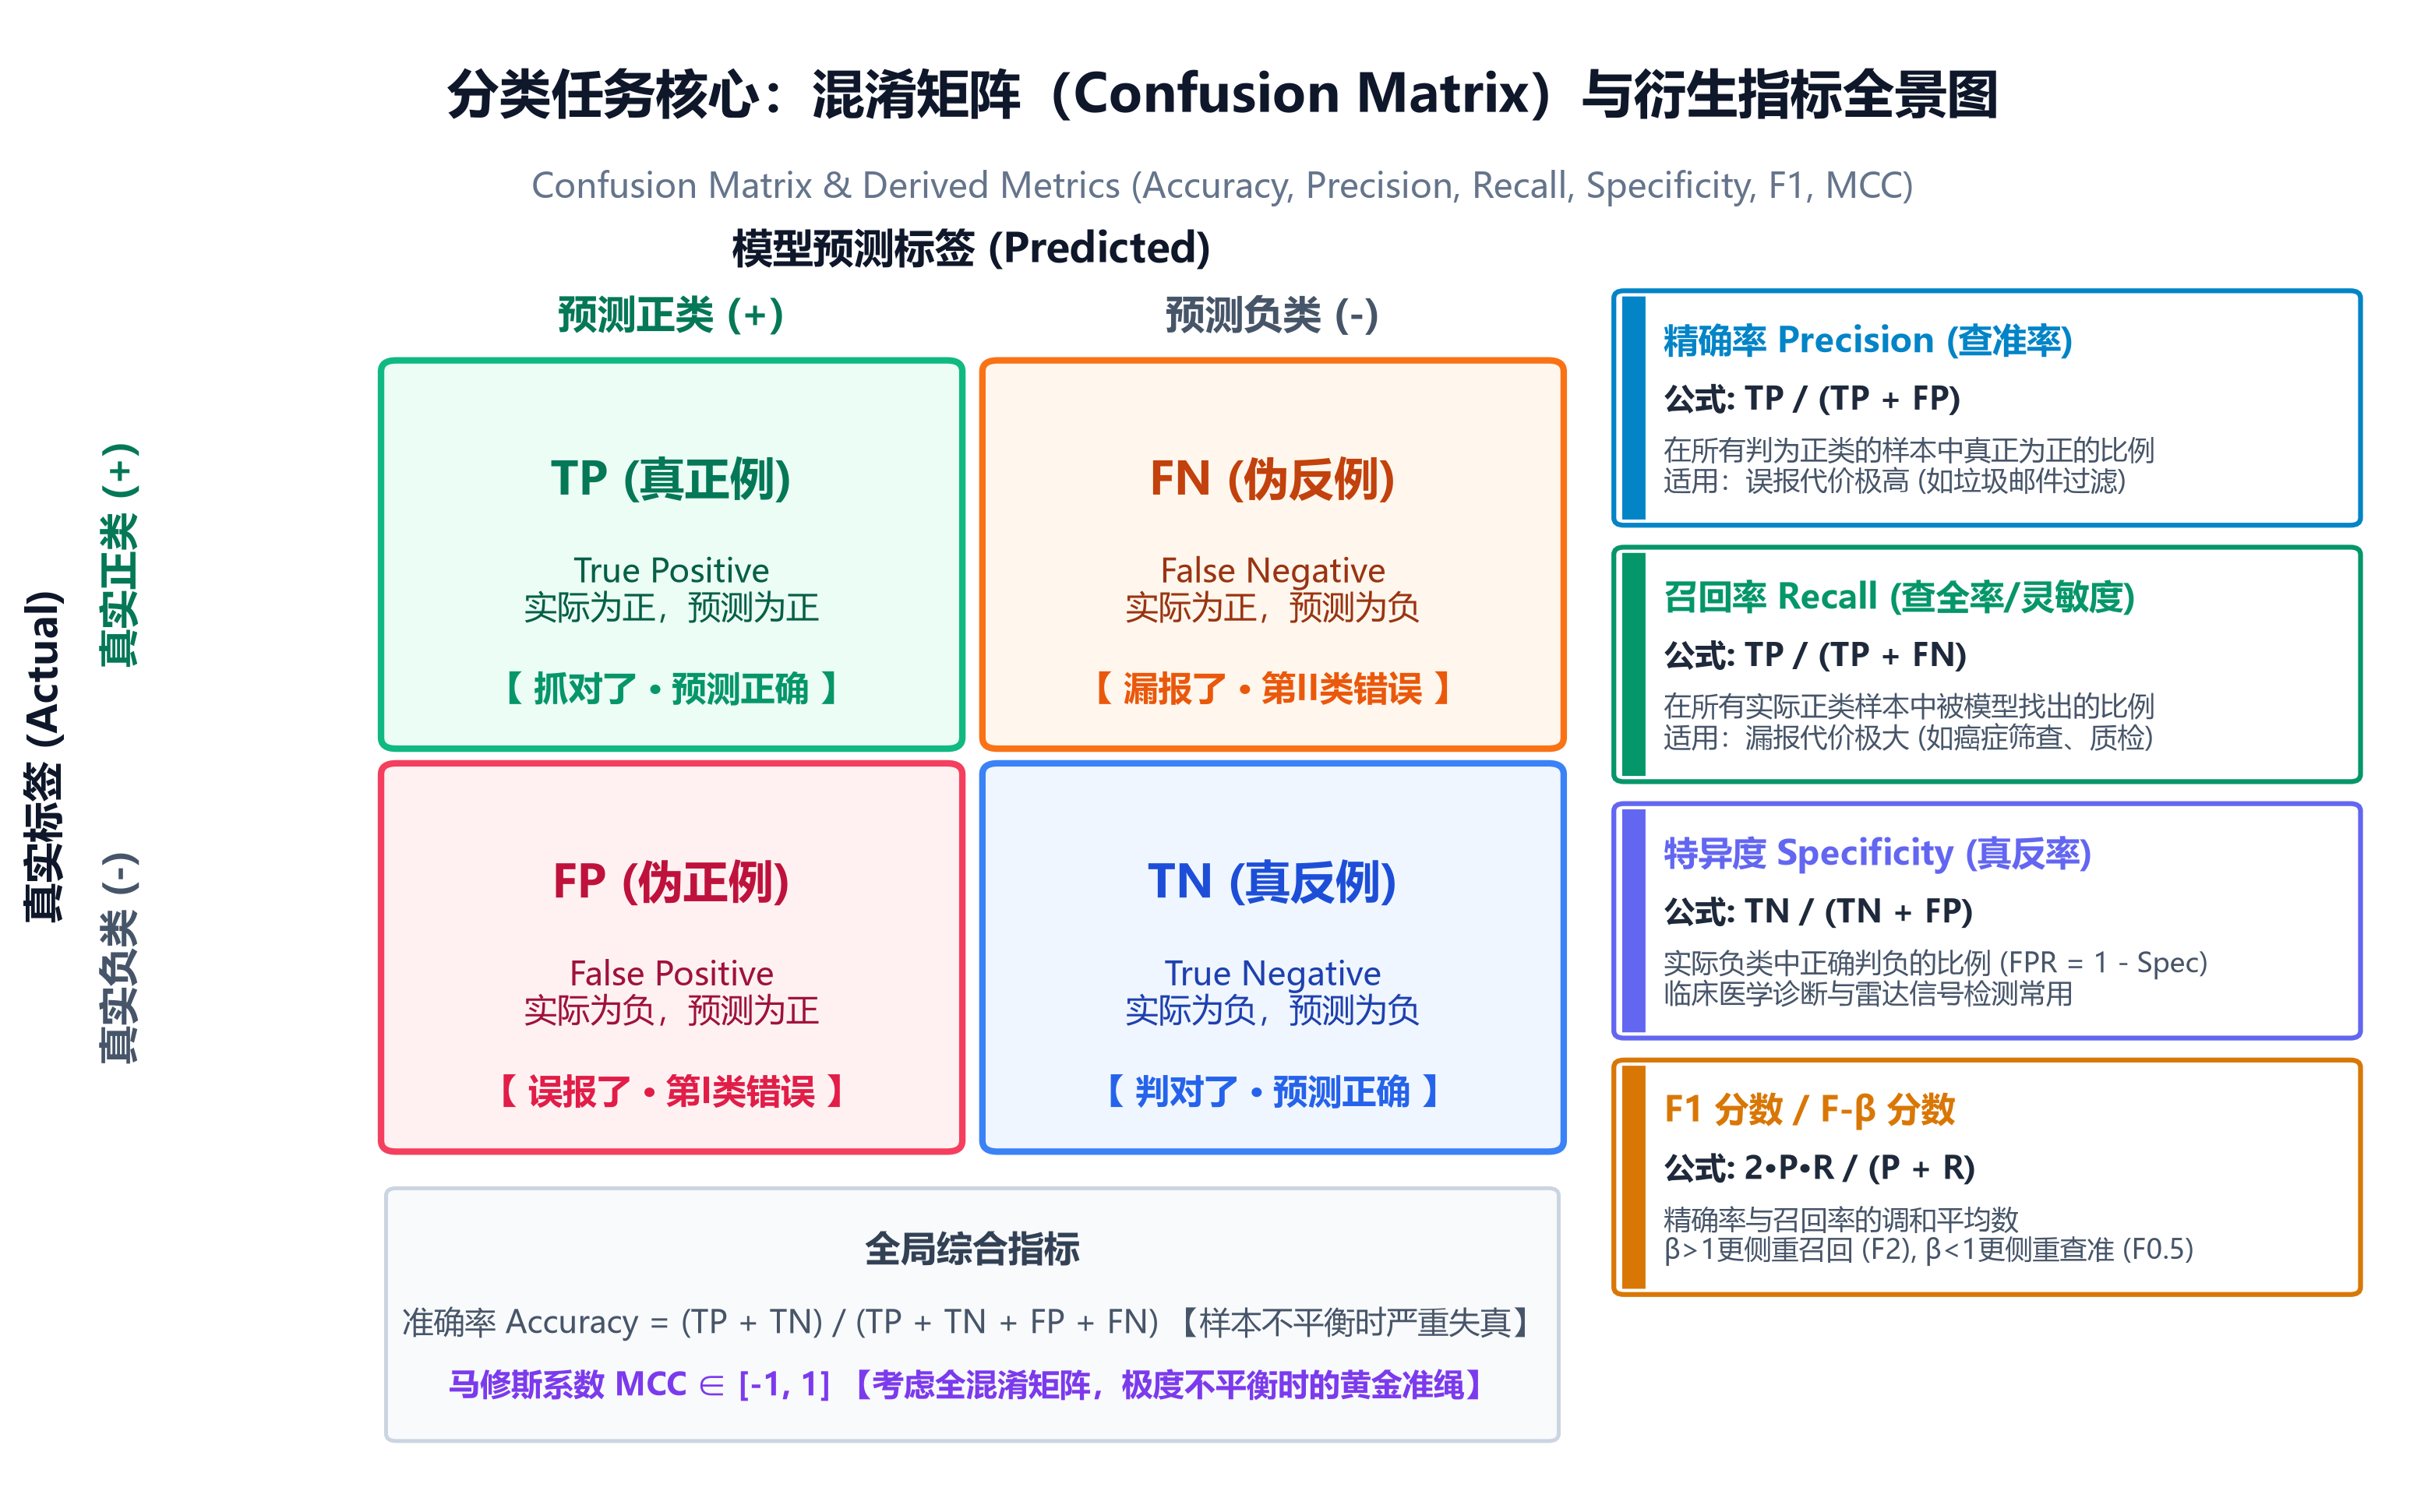
| 真实标签 \ 模型预测 | 预测为正类 (Positive) | 预测为负类 (Negative) |
|---|---|---|
| 真实为正类 (Positive) | TP (True Positive, 真正例) 实正判正,抓对了 ✔ |
FN (False Negative, 伪反例) 实正判负,漏报了 ✘ (第 II 类错误) |
| 真实为负类 (Negative) | FP (False Positive, 伪正例) 实负判正,误报了 ✘ (第 I 类错误) |
TN (True Negative, 真反例) 实负判负,判对了 ✔ |
样本总数记为:N = TP + TN + FP + FN。
1. 准确率(Accuracy)
计算公式:Accuracy = (TP + TN) / (TP + TN + FP + FN)
- 物理意义:所有样本中,被模型正确预测(正反两类都算)的比例。
- 核心缺陷(准确率悖论):对样本类别不平衡极其敏感。例如在患病率仅 1% 的疾病普查中,一个完全不具备诊断能力的“盲猜模型”若把所有人判为健康,准确率依然高达 99%,但该模型毫无医学实用价值。
- 适用场景:正负样本比例接近(大致 1:1),且对误报和漏报惩罚代价对称的任务。
2. 精确率 / 查准率(Precision)
计算公式:Precision = TP / (TP + FP)
- 物理意义:在所有被模型预测为正类的样本中,真正属于正类的比例。关注“模型挑出来的到底准不准”。
- 适用场景:误报(False Positive)代价极其昂贵的业务。例如:
- 垃圾邮件过滤:宁可漏放几封垃圾邮件(FN),也绝不能把重要业务合同或用户注册邮件误判为垃圾邮件丢弃(FP);
- 量化交易买入信号:每次触发买入指令都涉及真金白银交易成本,需要极高的胜率保证。
3. 召回率 / 查全率 / 灵敏度(Recall / Sensitivity / TPR)
计算公式:Recall = TP / (TP + FN)
- 物理意义:在所有实际为正类的样本中,被模型成功揪出来的比例。关注“正类目标有没有被漏掉”。
- 适用场景:漏报(False Negative)代价具有致命性的业务。例如:
- 癌症/急性心肌梗死早期筛查:宁可误报后安排进一步无创复查,也绝不能放过一个实际阳性患者;
- 地震/火警预警系统、工业生产关键部件裂纹探伤、反洗钱风险拦截。
4. 特异度(Specificity / TNR)与假正率(FPR)
计算公式:
• 特异度(True Negative Rate):Specificity = TN / (TN + FP)(所有实际负类中被正确判负的比例)
• 假正率(False Positive Rate):FPR = 1 - Specificity = FP / (TN + FP)(所有实际负类中被错判为正类的比例)
意义:在临床医学统计与雷达信号检测中,特异度与灵敏度是描述诊断试验性能的双子星;而在机器学习中,FPR 与 TPR(Recall) 则是绘制 ROC 曲线的核心横纵坐标。
5. F1 分数 与 F-beta 分数(权衡的艺术)
在绝大多数模型调整中,精确率与召回率存在天然的跷跷板效应(Trade-off):将判定阈值调高,精确率上升但召回率骤降;将阈值调低,召回率上升但误报增多。F 分数正是两者的调和平均数(Harmonic Mean)。
- F1 Score(权衡相等):
F1 = 2 × (Precision × Recall) / (Precision + Recall) = 2TP / (2TP + FP + FN)注:之所以采用调和平均数而非算术平均,是因为调和平均对极小值更敏感,只有当查准率和查全率都较高时,F1 才会高。
- F-beta Score(有侧重权衡):
F_β = (1 + β²) × (Precision × Recall) / (β² × Precision + Recall)• β = 1:即标准 F1 Score;
• β > 1(如 F2 Score):召回率权重是精确率的 β² 倍,更侧重召回(如罕见疾病筛查、高危风险风控);
• β < 1(如 F0.5 Score):更侧重精确率(如高确定性营销广告推送)。
6. 马修斯相关系数(MCC, Matthews Correlation Coefficient)
计算公式:
MCC = (TP × TN - FP × FN) / √[(TP + FP)(TP + FN)(TN + FP)(TN + FN)]
- 取值范围:
[-1, 1]。+1 表示完美预测,0 表示随机猜测,-1 表示预测与真实完全相反。 - 核心优势:极端样本不平衡时的终极黄金指标。MCC 综合考虑了混淆矩阵中的全部四个单元(TP, FP, FN, TN),即便正负样本比例达到 1:1000,只要模型表现不佳,MCC 就会迅速跌向 0 甚至负值,彻底规避 Accuracy 和 F1 分数在极端比例下的失真现象。
7. ROC 曲线与 AUC(Area Under Curve)
曲线定义:横坐标为 假正率 FPR(1 – Specificity),纵坐标为 真正率 TPR(Recall)。通过不断滑动分类阈值(Threshold 从 0 到 1)绘制出的平滑轨迹。
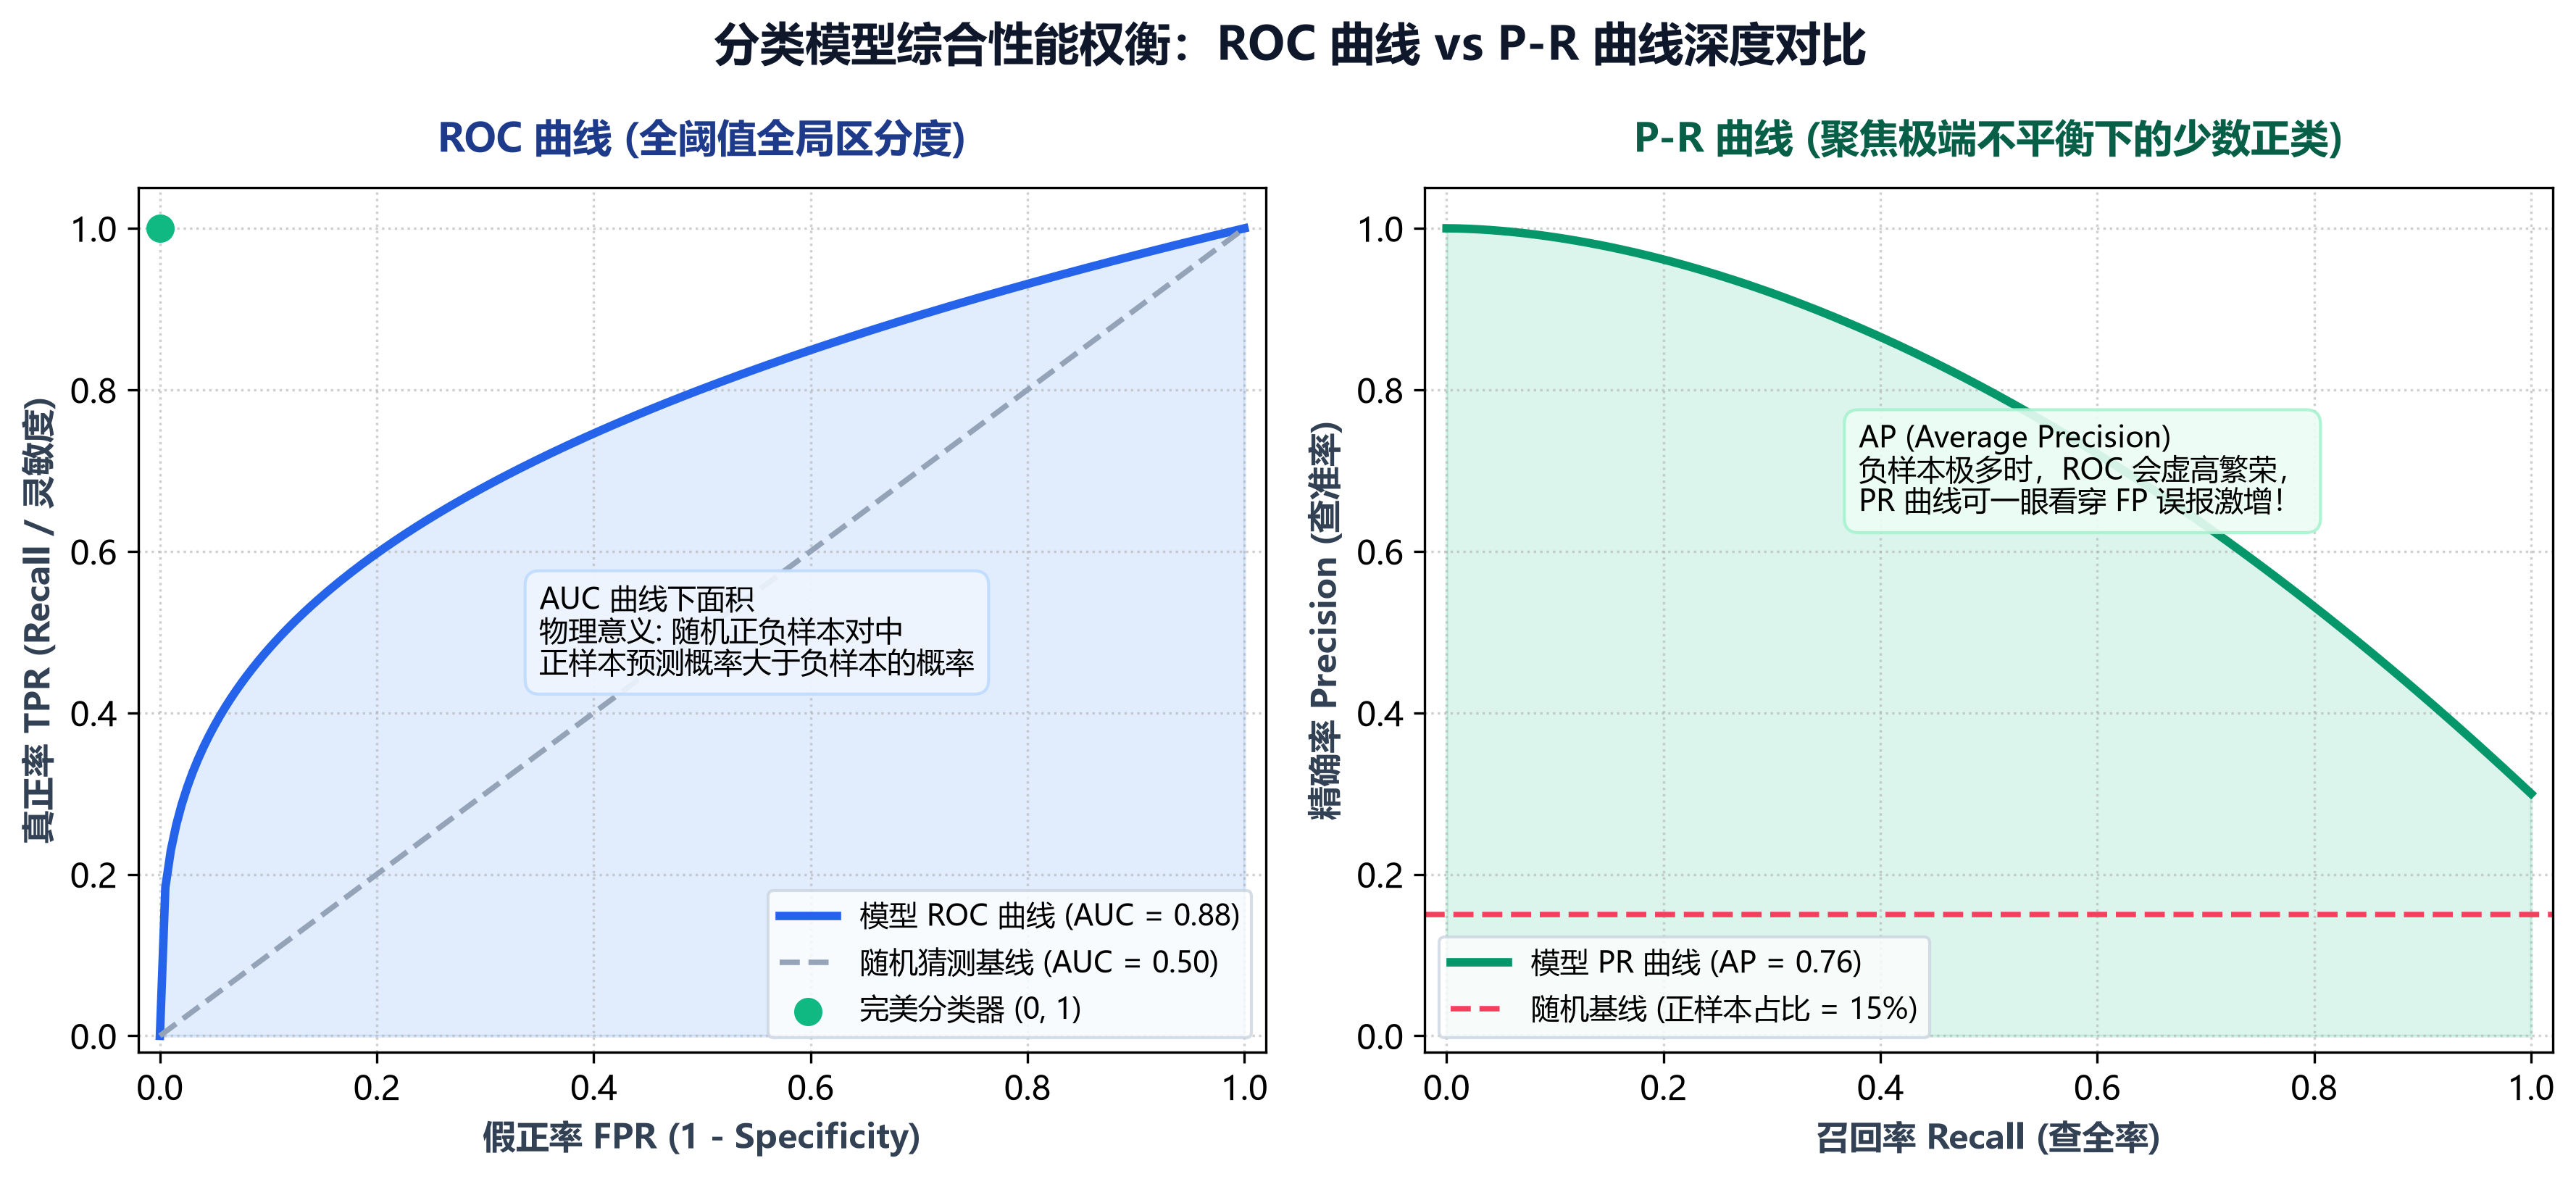
- AUC(曲线下面积):ROC 曲线与坐标轴围成的几何面积,取值在
[0.5, 1.0]之间。0.5 代表无辨别力的随机猜测(对角线),1.0 代表完美分类器。 - 统计学与物理意义:在测试集中随机挑选一个正样本和一个负样本,模型给正样本给出的预测概率大于给负样本预测概率的概率(等价于 Wilcoxon-Mann-Whitney 统计量)。
- 优势:不受固定决策阈值影响,直接反映模型全局排序识别能力;对样本的类别比例变化具有极强的稳定性。
8. PR 曲线与 AP / mAP(攻克极端不平衡)
曲线定义:横坐标为 Recall(查全率),纵坐标为 Precision(查准率)。
- AP(Average Precision):PR 曲线下的面积积分:
AP = ∫₀¹ P(R) dR ≈ ∑ₖ [Rₖ - Rₖ₋₁] × Pₖ - mAP(Mean Average Precision):在多类别目标检测或分类任务中,所有类别的 AP 平均值(如 COCO 数据集中的 mAP@0.5 或 mAP@[0.5:0.95])。
- ROC 与 PR 核心区别(必背避坑):当负样本数量极大(如网页搜索点击率仅 0.01%、目标检测海量背景候选框)时,FP 哪怕产生数万个错误,分母巨大的
FPR = FP / (TN + FP)依然微乎其微,使得 ROC-AUC 呈现出虚高的“虚假繁荣”;而 PR 曲线因为精准聚焦于正样本的Precision = TP / (TP + FP),只要 FP 增多指标立刻断崖式暴跌,因此在极端不平衡业务中,PR 曲线与 AP 比 ROC 更能反映模型真实表现!
9. 多分类评估的三大平均机制(Macro / Micro / Weighted)
在面对 3 个及以上类别的多分类任务时,通常需要将单类别指标综合计算:
| 平均方式 | 计算逻辑 | 核心关注点与适用场景 |
|---|---|---|
| Macro(宏平均) | 分别计算每一类的指标(如 P1, P2, P3),再直接求简单算术平均值。 | 平等对待每一个类别。对样本量极少的小类给予同等权重,适合需要重点监控长尾分布、冷门类别的任务。 |
| Micro(微平均) | 将所有类别累计的 TP、FP、FN 全部汇总相加,再统一套用公式计算。 | 平等对待每一个样本。大类别由于样本量大而占据绝对主导。 ★ 核心性质:在单标签多分类下,Micro-Precision = Micro-Recall = Micro-F1 = Accuracy! |
| Weighted(加权平均) | 分别计算各类别指标,并按其在总样本中的占比作为权重进行加权平均。 | 兼顾各类别独立表现与实际样本分布结构。 |
10. 对数损失(Log Loss / 交叉熵 Cross-Entropy)
二分类公式:
LogLoss = - (1/N) ∑ᵢ [ yᵢ · ln(pᵢ) + (1 - yᵢ) · ln(1 - pᵢ) ]
其中 yᵢ ∈ {0, 1} 为真实标签,pᵢ 为模型给出的预测概率。
- 物理意义:衡量模型输出的概率分布与真实分布之间的信息差(KL散度)。
- 惩罚机制:它对“过于自信但实际预测错误”的样本施加极其严厉的对数惩罚。例如当真实为 1 时,若模型预测 0.99,损失接近 0;若模型盲目自信预测为 0.01,单个样本损失便直接飙升至 4.6 以上。因此 Log Loss 能够强力约束模型的概率校准度(Probability Calibration)。
二、回归任务评价指标(Regression)
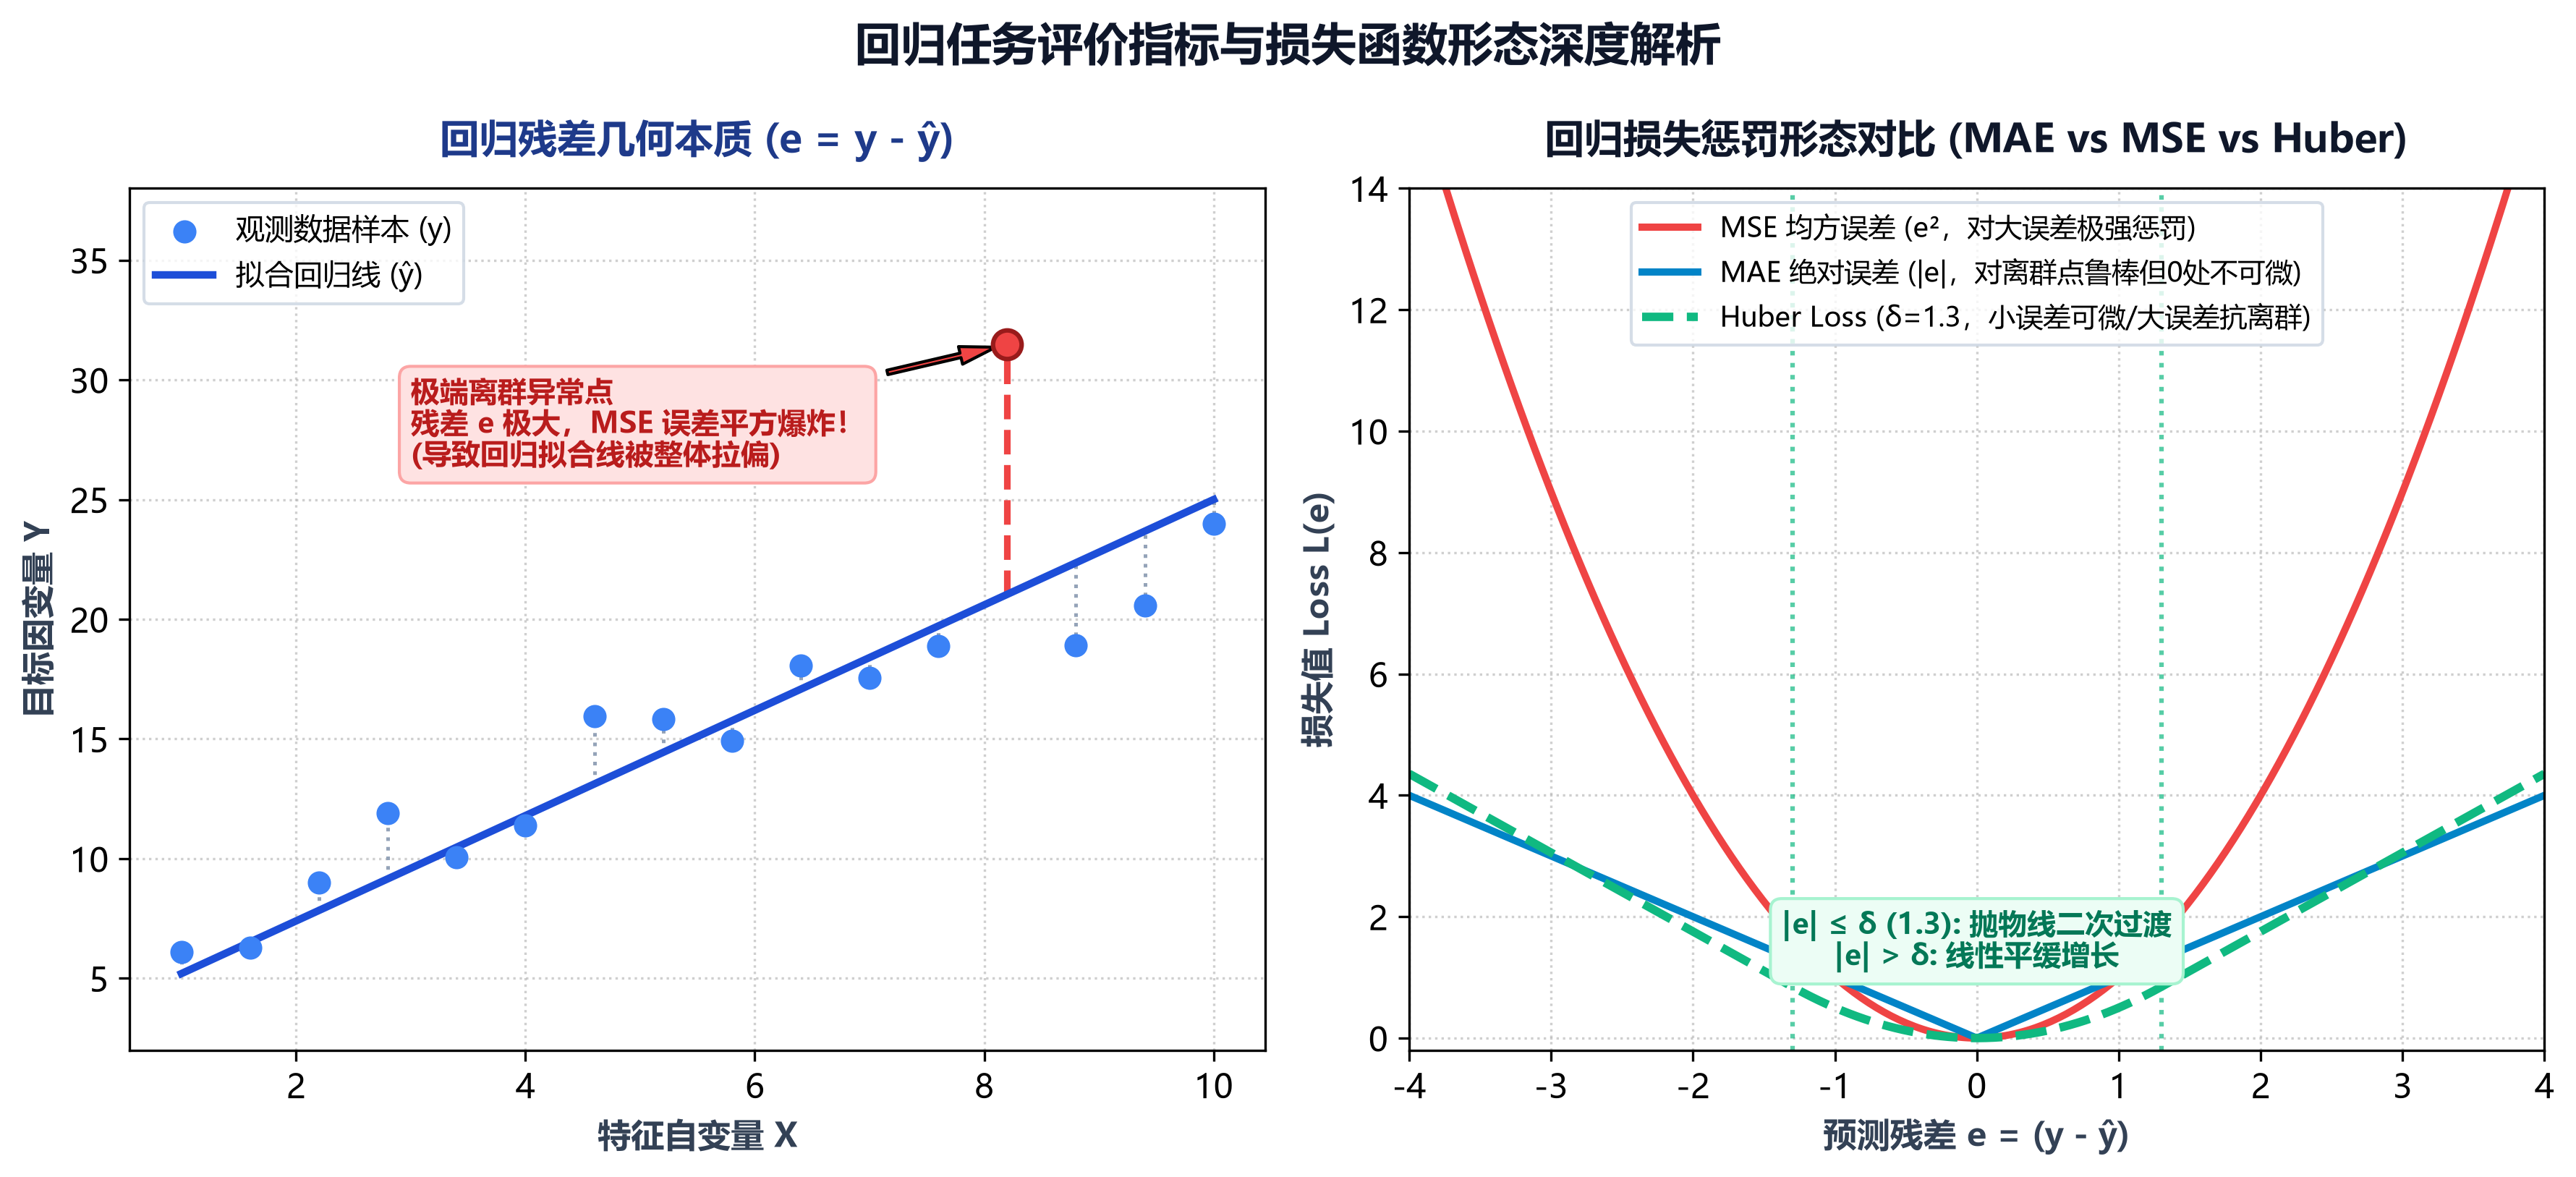
设真实值为 yᵢ,模型预测值为 ŷᵢ,真实值样本均值为 ȳ,总样本数为 n,残差定义为 eᵢ = yᵢ - ŷᵢ。
1. 平均绝对误差(MAE, Mean Absolute Error)
计算公式:
MAE = (1/n) ∑ᵢ |yᵢ - ŷᵢ|
- 特点与量纲:基于 L1 范数,量纲与原始数据完全一致。
- 鲁棒性:误差以线性增加,对离群点(异常值)较为宽容、鲁棒性好。
- 缺点:在误差为 0 处存在不可导的尖锐折点,作为优化目标时梯度计算需特殊处理。
2. 均方误差(MSE)与 均方根误差(RMSE)
计算公式:
• MSE = (1/n) ∑ᵢ (yᵢ - ŷᵢ)²
• RMSE = √MSE = √[ (1/n) ∑ᵢ (yᵢ - ŷᵢ)² ]
- 特点:基于 L2 范数,全域连续平滑、处处可导,是经典机器学习中最通用的损失函数之一。
- 平方放大效应:由于对残差进行了平方计算,大误差会被急剧放大(例如误差由 2 变成 10,惩罚暴增 25 倍)。对异常值极其敏感。
- RMSE 优势:开根号操作将量纲重新拉回至原数据量纲,物理意义直观(如房价预测误差直接体现为“元”)。
3. Huber 损失(Smooth L1 Loss:鱼与熊掌兼得)
计算公式:
当 |y - ŷ| ≤ δ 时:L_δ = 0.5 × (y - ŷ)²(采用 MSE 抛物线)
当 |y - ŷ| > δ 时:L_δ = δ × |y - ŷ| - 0.5 × δ²(采用平缓的 MAE 线性)
- 物理意义:在误差较小(
≤ δ)时保持平滑易优化的二次可导特性;在遇到离群异常值(> δ)时自适应退化为线性增长,避免梯度爆炸。 - 经典应用:目标检测边界框回归(Fast/Faster R-CNN 中的 Smooth L1 Loss)、稳健回归建模。
4. 平均绝对百分比误差(MAPE)与 对称百分比误差(sMAPE)
计算公式:
• 标准 MAPE:MAPE = (100% / n) ∑ᵢ |(yᵢ - ŷᵢ) / yᵢ|
• 对称 sMAPE:sMAPE = (100% / n) ∑ᵢ [ 2|yᵢ - ŷᵢ| / (|yᵢ| + |ŷᵢ|) ]
- 优势:无量纲相对误差。适合横向对比不同量级、不同币种或不同规模业务的预测表现(如某产品销售额 1000 万误差 5%,与小产品销售额 10 万误差 5% 具有可比性)。
- 缺陷与修正:当真实值
yᵢ = 0时标准 MAPE 会因分母为 0 导致崩溃;当yᵢ趋近于 0 时误差会剧烈虚高。改进版 sMAPE 引入分母对称项,有效避免了除零危机。
5. 均方根对数误差(RMSLE, Root Mean Squared Log Error)
计算公式:
RMSLE = √[ (1/n) ∑ᵢ ( ln(yᵢ + 1) - ln(ŷᵢ + 1) )² ] (要求 yᵢ ≥ 0)
- 物理意义:通过对数压缩削弱因数量级跨越过大(如粉丝数从几十人到几千万人、商品销售跨度极大)带来的影响。
- 非对称惩罚:对“预测偏小(欠预测)”的惩罚显著严厉于“预测偏大(过预测)”。在共享单车调度、电商备货等场景下极为实用——宁可稍微备多,绝不能断货停摆。
6. 决定系数(R²)与 校正决定系数(Adjusted R²)
计算公式:
R² = 1 - [ SS_res / SS_tot ] = 1 - [ ∑ᵢ(yᵢ - ŷᵢ)² / ∑ᵢ(yᵢ - ȳ)² ]
• SS_res:残差平方和(模型未能解释的波动误差)
• SS_tot:总平方和(基准均值模型自带的自然波动)
- 取值含义解读:
• R² = 1:完美拟合,残差全为 0;
• R² = 0:模型效果等于闭着眼睛盲猜样本均值
ȳ;• R² < 0:关键认知纠偏:R² 可以为负数!当 R² < 0 时,说明模型的预测效果比直接猜平均值还要糟糕。
- 校正决定系数(Adjusted R²):
R²_adj = 1 - (1 - R²) × [ (n - 1) / (n - p - 1) ](p为特征变量数)作用:在多元线性回归中,单纯堆叠无关冗余特征会虚高 R²。Adjusted R² 引入了变量惩罚机制,只有新加入的特征真正提升解释力时数值才会上涨。
三、排序 / 搜索 / 推荐系统指标(Ranking & Recommendation)
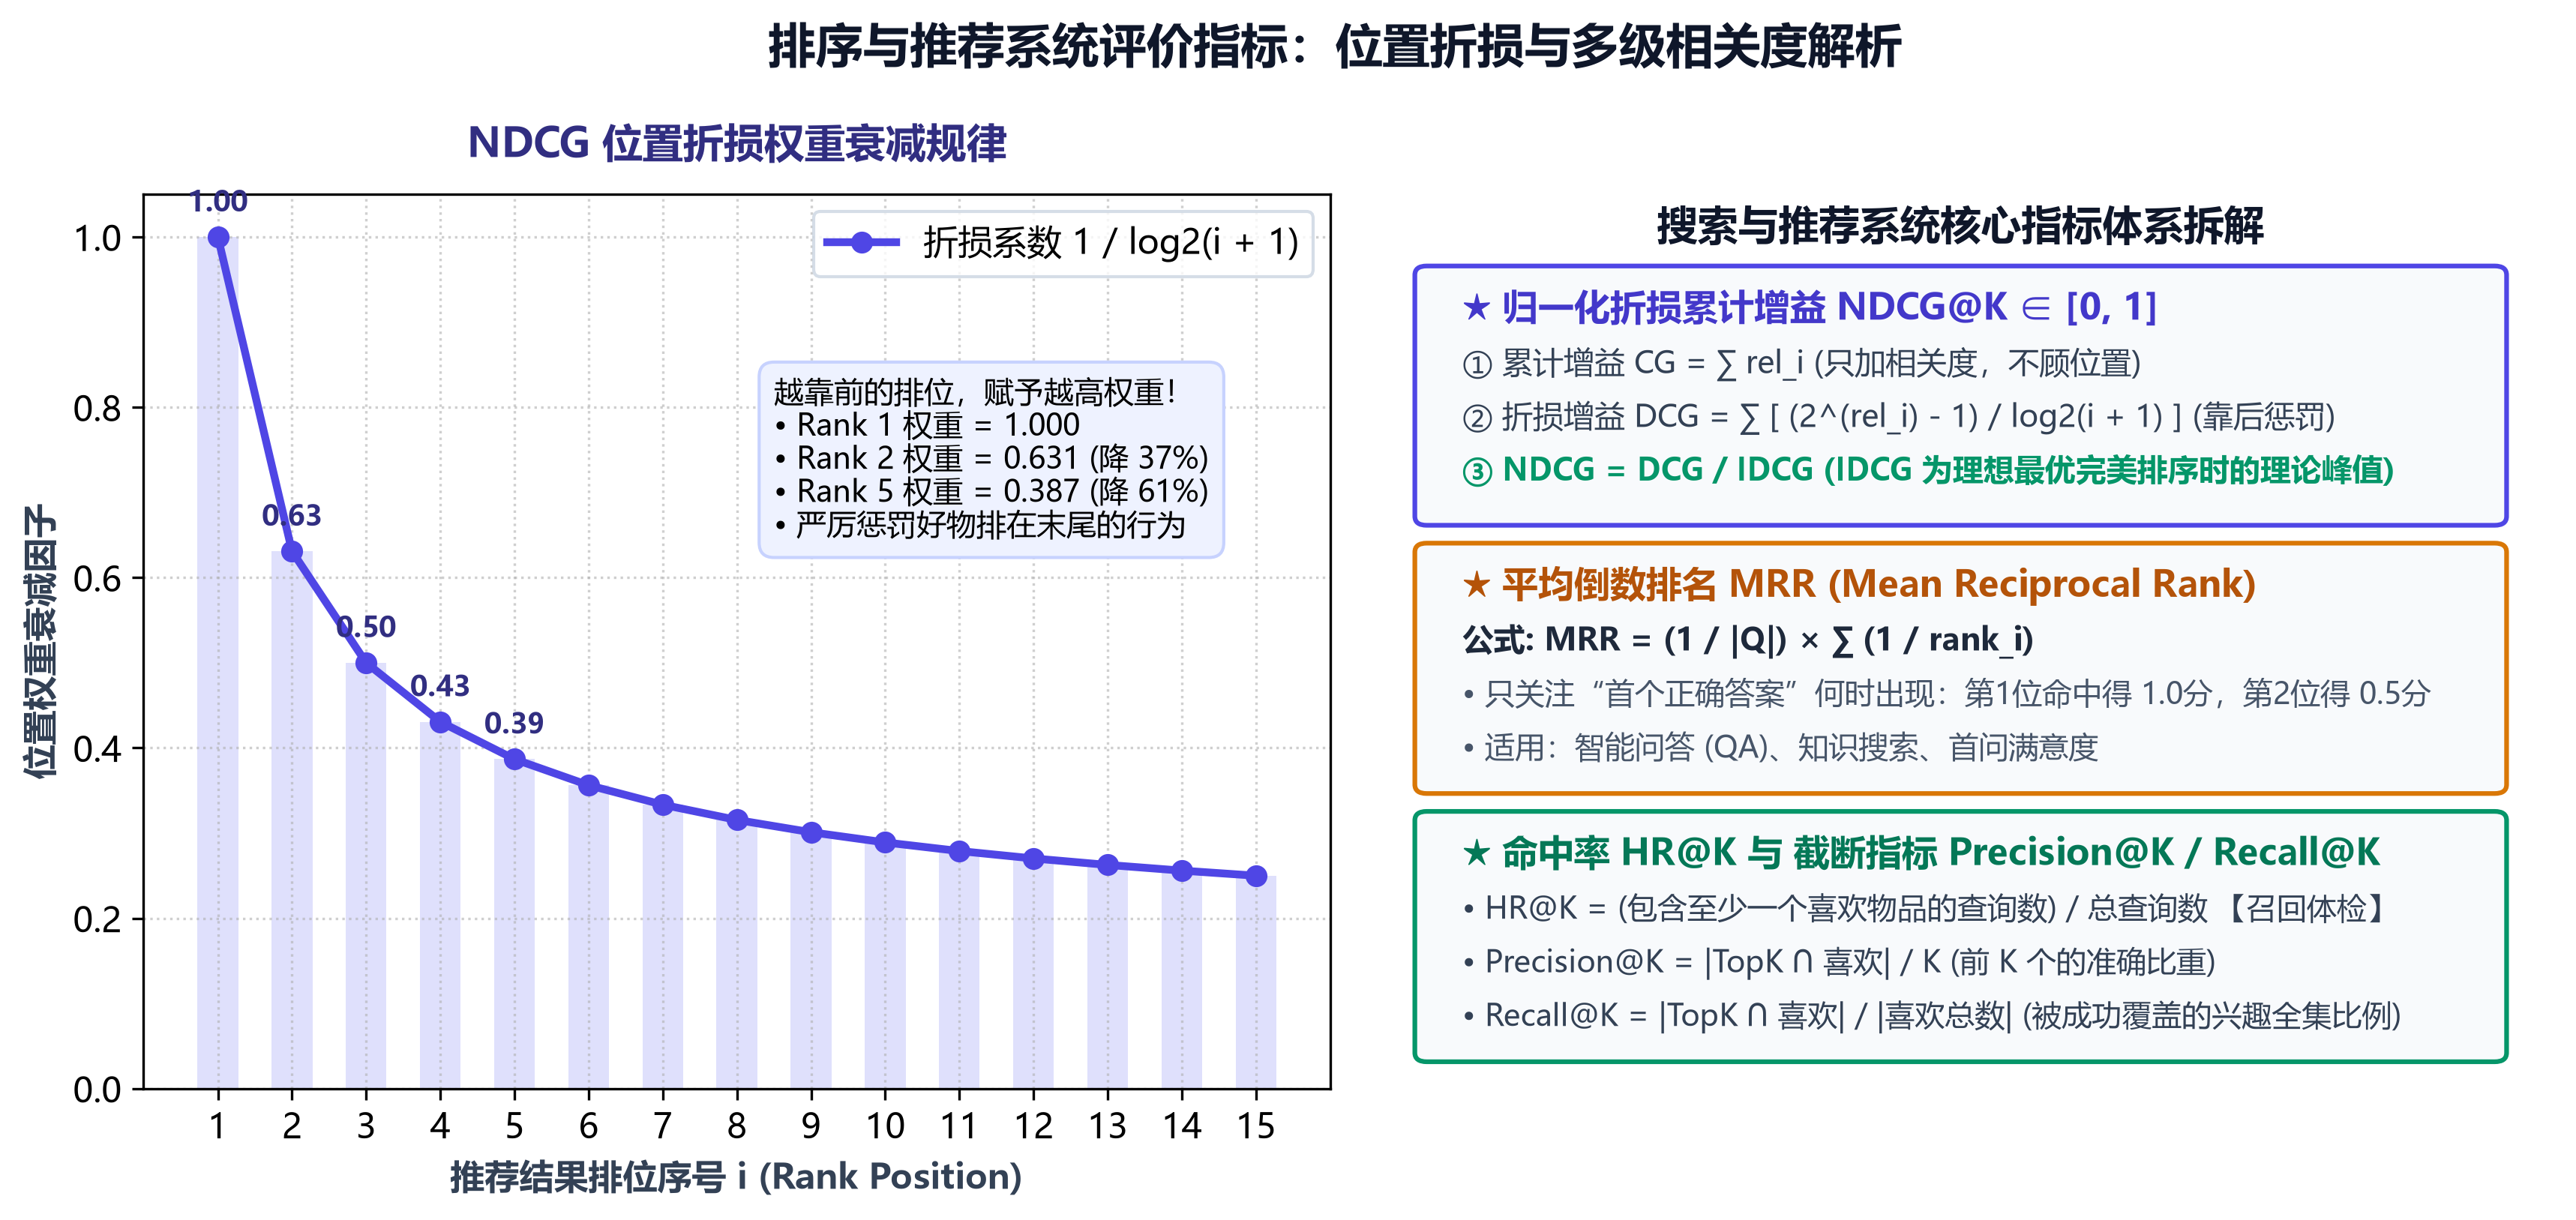
搜索与推荐场景与传统分类最大的不同在于:不仅在乎推得对不对,更极度苛求排位靠不靠前(位置敏感性)。
1. 命中率(Hit Rate @ K, HR@K)
计算公式:
HR@K = (前 K 个推荐列表中包含用户真实感兴趣物品的查询数) / 总查询数
场景:粗粒度评估推荐系统“有没有蒙中”。常用作召回阶段或模型第一轮快速初筛的健康度体检。
2. 精确率与召回率 @ K(Precision@K & Recall@K)
- Precision@K:在前 K 个推荐物品中,用户真正喜欢物品的占比
|Top-K ∩ Relevant| / K。 - Recall@K:用户在全库中所有喜欢的物品,被成功截取进前 K 个列表的占比
|Top-K ∩ Relevant| / |Relevant|。
3. 平均倒数排名(MRR, Mean Reciprocal Rank)
计算公式:
MRR = (1 / |Q|) ∑ᵢ (1 / rankᵢ)
其中 rankᵢ 是第 i 个查询中第一个命中相关结果所在的位置位次。
场景与特点:只认“第一个正确答案”何时出现。首位命中得 1 分,第 2 位得 0.5 分,第 10 位仅 0.1 分。非常适用于智能客服单轮问答、知识库搜索、Factoid QA 等用户只要找到一个满意解答便结束查询的场景。
4. 归一化折损累计增益(NDCG@K, Normalized Discounted Cumulative Gain)
工业级搜索引擎和信息流推荐的定海神针。它完美融合了两个核心业务规律:① 结果有“好中差”的多级相关度;② 用户越往后翻耐心越低(位置衰减)。
- 累计增益(CG, Cumulative Gain):前 K 个结果的相关度直接相加:
CG_K = ∑ᵢ₌₁ᴷ relᵢ(无视排序次序)。 - 折损累计增益(DCG, Discounted Cumulative Gain):对排在靠后的物品施加对数级权重惩罚:
• 标准版:
DCG_K = ∑ᵢ₌₁ᴷ [ relᵢ / log₂(i + 1) ]• 工业界强化版(更奖励顶级相关物):
DCG_K = ∑ᵢ₌₁ᴷ [ (2^(relᵢ) - 1) / log₂(i + 1) ] - 理想折损累计增益(IDCG, Ideal DCG):将该推荐候选集按相关度从高到低进行完美排序时算得的理论最高 DCG。
- 归一化(NDCG):
NDCG_K = DCG_K / IDCG_K(严格归一化到[0, 1]之间,消除不同查询候选集大小差异)。
四、聚类任务评价指标(Clustering)
聚类属于无监督学习,通常分为内部指标(无需真实标签)与外部指标(有基准标签)两大类别。
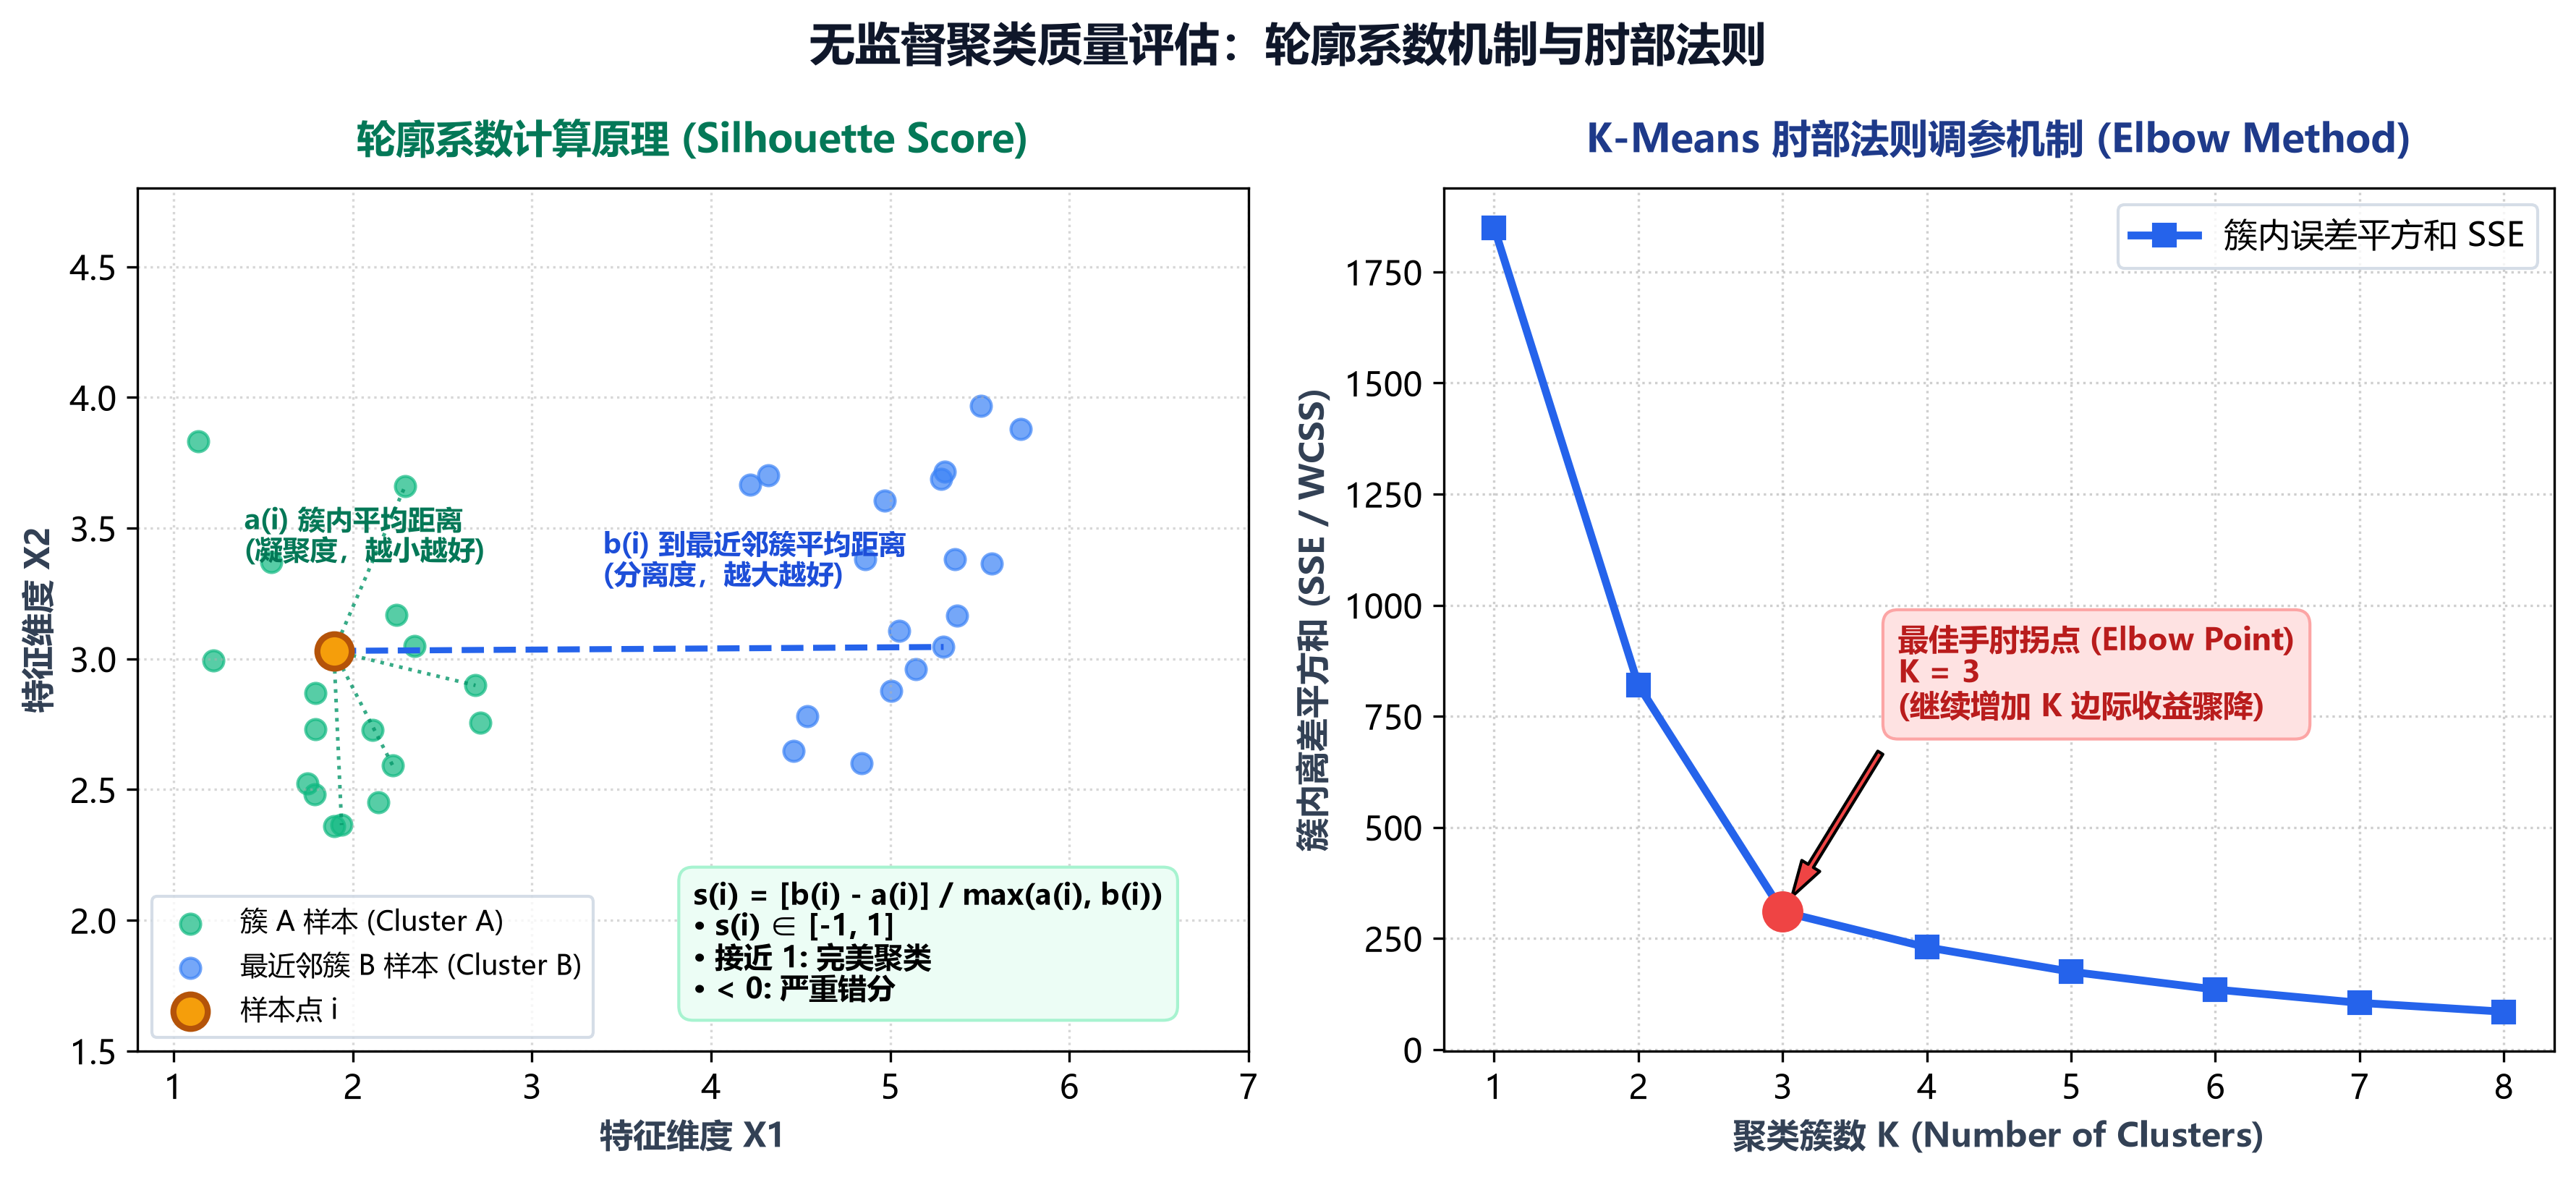
1. 内部评估指标(无需 Ground Truth 真实标签)
- 轮廓系数(Silhouette Coefficient):
对于单个样本
i:s(i) = [ b(i) - a(i) ] / max( a(i), b(i) )•
a(i):样本i到同簇其余样本的平均距离(簇内紧凑度 / 凝聚度,越小越好);•
b(i):样本i到最近邻簇所有样本的平均距离(簇间分离度,越大越好);• 取值解读:范围在
[-1, 1]。越接近 1 说明簇内聚拢、簇间疏离,聚类效果极佳;接近 0 说明处于两簇边界;若为负数说明被错误归并到了错误的簇。全局轮廓系数为所有样本的均值。 - Calinski-Harabasz 指数(CH 指数 / 方差比准则):
计算簇间离差矩阵与簇内离差矩阵的比值。数值越大越好。计算复杂度低、计算极快,常用于海量数据聚类簇数优选。
- Davies-Bouldin 指数(DBI):
衡量任意两簇的簇内距离之和与两簇中心距离的比值最大值。数值越小越好。
- 肘部法则(Elbow Method 与 SSE / WCSS):
以聚类簇数
K为横轴,以簇内误差平方和SSE = ∑∑ ||x - μ_k||²为纵轴。随着 K 增大,SSE 必然单调递减;在达到真实簇数前,SSE 会急剧下降,达到真实簇数后下降趋势显著放缓。曲线拐点(手肘 Elbow 位置)即为最具性价比的最佳 K 值。
2. 外部评估指标(拥有真实标签以供检验)
- 调整兰德指数(ARI, Adjusted Rand Index):
统计两两成对样本在真实划分与预测簇中的标签一致性(同在同簇、同在异簇)。取值范围
[-1, 1],通过扣除“随机乱分也能碰巧对一部分”的期望,真实反映聚类重合度,0 代表随机分配。 - 标准化互信息(NMI, Normalized Mutual Information):
借助信息论中互信息与熵的概念,衡量聚类划分结果所保留的真实类别信息量。取值范围
[0, 1],不受簇标签重命名的影响。
五、机器学习评价指标选择速查小结(避坑决策树)
| 任务业务特征 | 首选 / 必选评价指标 | 慎用 / 避坑备选指标 | 选型核心逻辑与避坑理由 |
|---|---|---|---|
| 平衡分类任务 (正负样本约 1:1) |
Accuracy、ROC-AUC | – | 样本均衡时准确率最直观,ROC-AUC 展现全局概率区分度。 |
| 极端不平衡分类 (如正样本 < 5%) |
PR-AUC (AP)、F1-Score、MCC | Accuracy (严重虚高) ROC-AUC (易被海量负样本粉饰) |
无脑猜大类即可骗取 99% Accuracy;海量负样本压低 FPR 导致 ROC-AUC 虚高。MCC 和 PR 曲线方能揭示真相。 |
| 欺诈/疾病/缺陷拦截 (漏报代价致命) |
Recall (查全率)、F2 Score | Precision (单看易误导) | 漏放一个患者或严重缺陷会造成毁灭后果,优先将阈值调低保 Recall。 |
| 垃圾信息拦截/死刑判决 (误报代价极高) |
Precision (查准率)、F0.5 Score | Recall (单看易误导) | 宁可漏网,绝不可冤枉正常用户邮件或合法操作。 |
| 普通回归预测 (对大误差敏感,需强惩罚) |
RMSE、MSE | MAE (惩罚不够强) | 平方项能够重度威慑离群大误差,平滑易求导。 |
| 含脏数据 / 强异常值回归 | MAE、Huber Loss (Smooth L1) | MSE、RMSE (容易爆炸) | 个别极端噪点残差平方后会强行拉偏整个拟合平面,MAE/Huber 具备天然免疫力。 |
| 跨越多个数量级回归 (如销售额/粉丝量) |
RMSLE、sMAPE | 标准 MAPE (分母为0时崩溃) | 对数压缩削弱量级悬殊冲击,且非对称特性重点防范欠预测断货。 |
| 电商/信息流长列表推荐 | NDCG@K | 普通 Accuracy / Precision | 兼顾多级相关度,并通过对数衰减重罚将好物排在末尾的行为。 |
| 问答搜索 / 首答即走 | MRR | – | 只关注第一个正确答案出现的位次(排第一得满分,排第十只得0.1分)。 |
| 无标签聚类 K 值调优 | 轮廓系数、肘部法则 (SSE)、CH 指数 | – | 肘部法则快速框定大致范围,轮廓系数精细检验簇内紧凑度与簇间分离度。 |
总结:在真实工程落地中,没有放之四海而皆准的“万能指标”。深入理解每一个公式背后的几何本质、统计假设与业务损失成本,才是构建高可靠机器学习系统的核心所在。
